作者:Jack OmniXRI, 2023/7/3
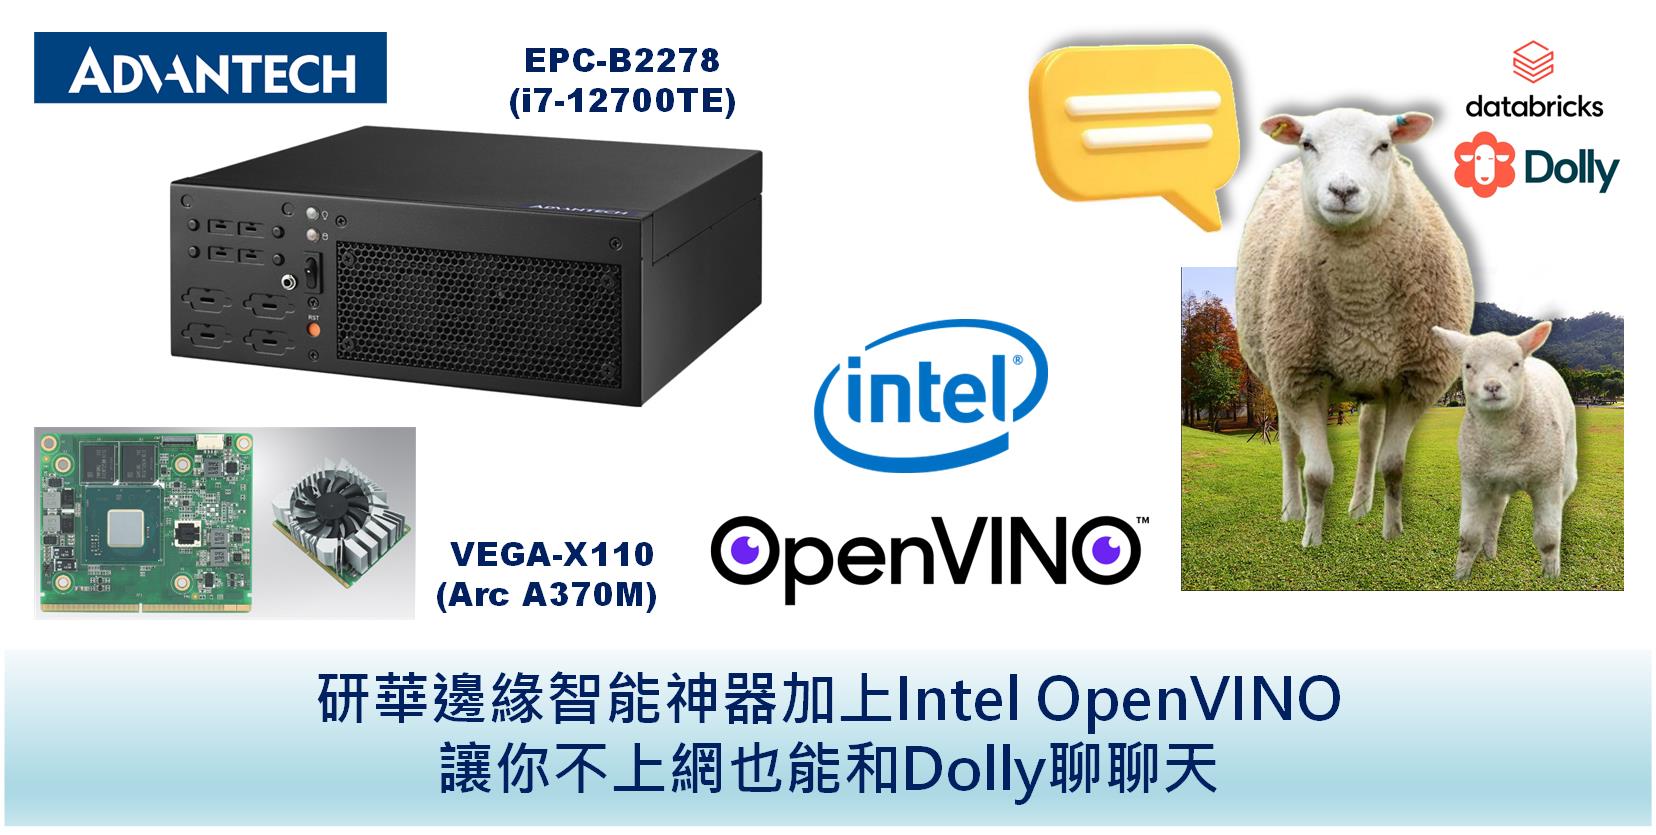
相信大家最近幾個月都被大型語言模型(Large Language Model,LLM)及人工智慧生成內容(Artificial Intelligence Generated Content, AIGC)給驚豔(驚嚇)到了吧!?好像科幻電影「鋼鐵人」中的虛擬管家「賈維斯(Jarvis)」已經被實現出來了,如果家裡也能有一套,那該有多好啊。目前此類 AI 模型多半都非常巨大,通常只能透過雲端伺服器的強大算力才能運行。為了也能在單機上運行,開始有一些較小規模的模型搭配超強的CPU及GPU也能順利達到交談互動、文章生成等應用。
以往在AI模型部署優化及推論部份,通常都會想到使用 Intel OpenVINO,不過大家多半只注意到它在「電腦視覺」相關的應用,殊不知自從2022.1版後就已開始加入許多「自然語言」的範例。而最近2023.0版又更加強GPU(內顯HD Graphic, Iris,獨顯Arc)處理記憶體動態外形(Dynamic Shape)的能力,使得如生成型預訓練變換模型(Generative Pre-trained Transformer,GPT)這類基於轉換器(Transfomer)技術的大型語言模型能得到更好的實現。
此次很榮幸得到國內外知名工業電腦大廠「研華科技」提供最新的小型工業電腦主機 EPC-B2278 [1](Intel 12代CPU, i7-12700TE)進行測試,其中硬體部份還加入 Mobile PCI Express Module(MXM) 介面的 VEGA-X110 [2],即 Intel 最新獨立顯卡(Arc A370M) ,用來加速AI應用計算。而軟體部份則搭配 Intel OpenVINO 2023.0 來進行LLM模型優化及推論。
為了測試LLM的推論的效能,這裡使用了OpenVINO Notebooks範例中的 GPT-2 文字生成及開源 Dolly 2.0 對話生成進行測試。以下就依序從自然語言對話技術發展歷史、運行系統的硬體規格、軟體開發環境及LLM實驗結果來幫大家介紹一下。





作者:Jack OmniXRI, 2023/5/3
說到小型電腦主機,大家大概第一個就會想到樹莓派吧?如信用卡般尺寸加上完整的週邊及充足的開源開發資源,讓開發者們愛不釋手。幾年前人工智慧(AI)開始興起時,大家也是馬上拿來應用於小型語音及視覺應用。不過沒多久大家就發現要運行深度學習模型所需的算力遠遠高出樹莓派CPU (Arm Cortex-A53/72 x4 Core@1.2~1.8GHz) 所能提供的。於是又有了像Intel神經計算棒(Neural Compute Stick)這類AI加速計算的外掛裝置出現,但其算力還是只能應付小尺寸(640x480像素以下)影像或要求檢測速度不高(每秒1~3張)的場景。對於實際場域高效電腦視覺應用(如物件偵測、影像分割等),一般就得配置一台大型桌機加上Nvidia GPU顯卡才能達成AI推論需求。好在隨著半導體技術的突飛猛進,兼具高效計算及迷你尺寸的主機已不再是遙不可及。其中Intel和許多廠商合作推出的NUC (Next Unit of Computing) 系列產品[1]從入門款(Celeron N4505 CPU + UHD 16EU GPU)到高階款(Core i7 13Gen CPU + Iris 96EU GPU)一應俱全,讓開發者在性能及價格選用上有了更大的彈性空間。
為了更進一步了解這類迷你主機在AI推論效能的表現,此次選用了東擎(ASRock Industrial) NUC BOX-1260P作為主要實測硬體(以下簡稱測試機),AI推論部份則選用OpenVINO 2022.3版作為基礎工具。而測試項目則使用OpenVINO Notebooks中最新的物件偵測「Convert and Optimize YOLOv8 with OpenVINO」範例作為實測效能的分析。以下就開始展開逐一說明。